はじめに
生成 AI 関連を仕事上追わなければならないのですが、最近のトレンドはハエの脳ミソをモデル化して学習させて遊ぶことなんだそうです。もう訳わかんねぇな・・・となってたのが先週まで。
今週は全く違う話題。『Jev』。
なんだよそれ・・・また調べることが増えたお・・・。
俺 ワンショットの推論しか知らねえんだよ・・・。
端的に言うと、ぼちぼち頭の良いモデルが 安価/超高速で判断を下すことに特化したモデルなんだそうです。
ワークフローなどにおいて、生成 AI の適用範囲というのは極小化すべきであって、ルールベースや閾値・プログラム判定で行えることは AI 化すべきではないのですが、この Jev はそのルールベースの範囲を少しだけ拡張、いや曖昧にする。
つまり、ルールベースで判断するべきところに 人間の肌感覚を入れたいときに活躍するわけです。すごい IF 文。
面白そうなので珍しく使ってみることにしました。
この投稿も随時加筆修正されるかも知れない。
今回思いついた使い所
例えば、VJ やってるときに イベントのハッシュタグを自動的に拾ってリアルタイムでニコニコ動画みたいに流す仕組みを思いついたとしましょう。
しかし、それを全スルーで流しっぱにすると良からぬ文字列が投稿されたりする可能性があります。
平たく言うと、下ネタみたいなワードが、皆様の眼の前で大画面でスクロールしちゃうわけです。
対策としては全て人間が目を通すか、よろしくないワードを沢山あつめた NG ワード辞書作るか。
理想としては前者ですが、全部みていると大変だし放置もできない。
後者のように辞書作ってルールベース当てはめようとしたとして、
スパムとか悪口投稿みたいなのは防げません。隠語とか。
というかなんでそんなキモい辞書つくらなあかんねん。
じゃあ LLM で毎回処理すれば良いのではと思うのですが、
・遅い
・早いモデルはあまり頭よくない
・頭よくないモデルは、JSON を返す時に たまにパースが壊れる
と安定しません。
やったことある方ならわかると思いますが、JSON 壊されるのはもうどうしようも有りません。
あとチリツモで金も掛かるかも知れない。
Jev はこのあたりに特化していて、生成をせずに判断だけをするので、
与えた JSON を破壊することも多分しないのです。しかも出力は現状タダ。
今回のユースケース
与えたプロンプト例
イベント中のハッシュタグをリアルタイム実況させるうえで、
Jev の判断においては、
・イベントに関係する内容か?
・攻撃的でないか?
・スパムではないか?
が主な判断基準になると考えました。
{
  "state": "【評価対象の投稿本文】\n 「イベント楽しい!!」",
  "questions": {
    "is_live_event_related": {
      "type": "boolean",
      "instructions": "この投稿は、イベントのリアルタイムな盛り上がり、ステージ・DJ・演奏・発表へのリアクションや感想、実況、ツッコミ、参加者の興奮に関連していますか?単なるハッシュタグ悪用の無関係な宣伝やBotでなければ true と判定してください。"
    },
    "is_spam": {
      "type": "boolean",
      "instructions": "この投稿は、イベントのハッシュタグを悪用した副業勧誘、アフィリエイト、プレゼント詐欺、Botによる定型文、無関係なハッシュタグ乱用などの迷惑スパムですか?"
    },
    "is_negative": {
      "type": "boolean",
      "instructions": "この投稿には、個人への悪意ある誹謗中傷、嫌がらせ、過度な攻撃、差別、悪口が含まれていますか?\n※イベント実況特有のユーモア、ツッコミ、スラング、興奮表現(例:「まずい」「なんで」「草」「やばい」「訳ないだろ」など)はネガティブではなくポジティブな盛り上がり表現として false と判定してください。"
    }
  }
}
この例だとコメント『イベント楽しい!!』について、3つの観点で YES / NO を判定せよと指示しています。
※内容は適当に書き換えてます
Jev が返す JSON
今回は質問に対する確率値 probability ( 0.00〜 1.00 )が返されます。
{
  "answers": {
    "is_live_event_related": {
      "type": "boolean",
      "probability": 0.76
    },
    "is_negative": {
      "type": "boolean",
      "probability": 0.02
    },
    "is_spam": {
      "type": "boolean",
      "probability": 0.03
    }
  },
  "usage": {
    "inputTokens": 401,
    "outputTokens": 63,
    "totalTokens": 464
  }
}
今回のプログラム側では、それぞれに閾値を設けており、
Jev が返した結果が 閾値を上回っていれば/下回っていれば合格/不合格としました。
以下は プログラム側で再加工した JSON。
{
  "model": "typesafe-ai/jev",
  "overall_score": 0.722,
  "items": [
    {
      "key": "event_related",
      "name": "イベント進行関連度",
      "prob": 0.76,
      "threshold": 0.3,
      "condition": "≥ 0.30",
      "passed": true,
      "desc": "リアルタイム進行・発表内容・会場に関する言及"
    },
    {
      "key": "negative",
      "name": "批判・ネガティブ度",
      "prob": 0.02,
      "threshold": 0.3,
      "condition": "≤ 0.30",
      "passed": true,
      "desc": "登壇者・他者への攻撃、批判、不満、冷笑"
    },
    {
      "key": "spam",
      "name": "ハッシュタグスパム度",
      "prob": 0.03,
      "threshold": 0.2,
      "condition": "≤ 0.20",
      "passed": true,
      "desc": "タグ乱用、便乗宣伝、アフィリエイト、Bot投稿"
    }
  ]
}
この結果であれば、それぞれ基準をクリアしているので晴れて投稿可能になります。
この処理を1秒未満で実施してくれるので、Jev により ほぼリアルタイムで採用/不採用の判断が可能となったわけです。
だらだら推論の内容を垂れ流す LLM ではこのスピード感は簡単には得られません。
なお、直近の投稿だけに絞り込むとか、既に流したかどうかの管理だとか、
そういうのはプログラム側でルールベースで制御できるので Jev には判断させません。
注意点としては、ハルシネーションはほぼ 起きませんが、
Jev は失敗(誤った判断をくだす)しないわけではない です。
確信度が低い場合は、「分からない」扱いするという実装がプログラム側で必要になる場合があります。
動作例
今回やったことはツイートに整理されているのですが、作ったアプリのコントローラ画面です。
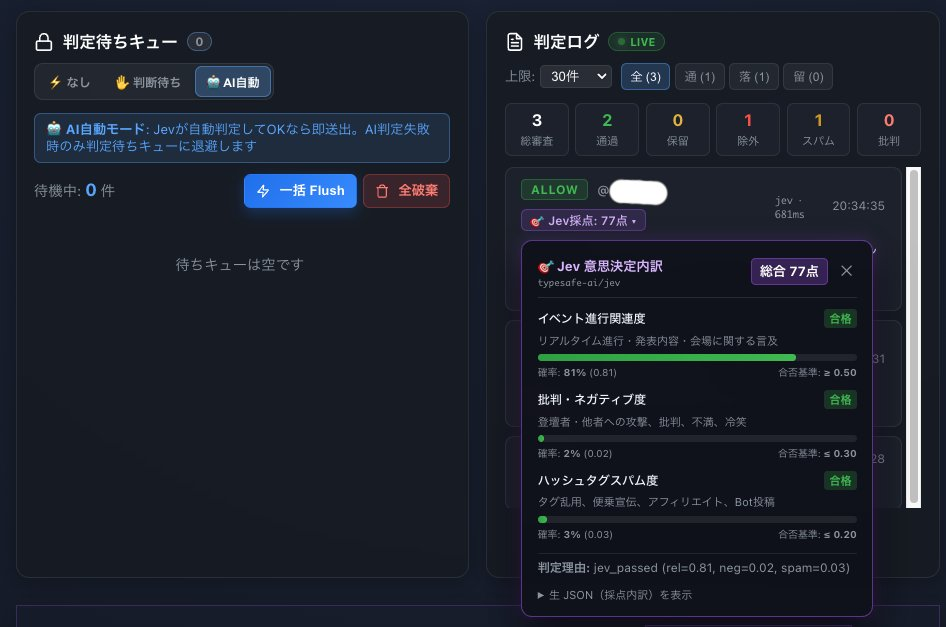
本家はウェイトリストになってて使えないので、代替手段として Vercel AI Gateway 経由で Jev の API を実行していますが、「jev_http_error_429: Free tier requests on this model are rate-limited.」 ばかりくらうので早く本家に課金させてほしい。。。
(と思ったら、この記事投稿して数分後に ウェイトリスト来た)
